私は自由な時間を、特に美味しいコーヒーを片手に、素敵な本を読むことに費やしています。特に、書店をぶらぶらと歩き、棚を見て回り、思いがけない読み物を発見するのが楽しい。そんな中、一冊の本に出会い、すぐに興味を引かれた:
予測機械 Ajay Agrawal、Joshua Gans、Avi Goldfarb著。
正直に言おう。最近、AI/MLについて少しも興味を持たない人を挙げることができるだろうか?著者はこの本の中で 「AIの単純な経済学と、その技術がどのようにポイントソリューションに使われているかを説明している。.この本のある章では、次のような記述が目立った:
予測が良くなれば、様々な行動の報酬を考える機会が増える。つまり、判断する機会が増えるということだ。
本書はAIと機械学習に焦点を当てているが、エンジニアリング・シミュレーション、特にCFDの世界でも同じ考え方が当てはまるため、この言葉は私の心に響いた。シミュレーションの意図に関係なく、エンジニアにとって、より速く、より良い情報に基づいた設計上の意思決定を行う能力は非常に重要です。技術革新と競争力維持のプレッシャーは、生産性の向上とシミュレーションワークフローの高速化の必要性を高めるばかりです。
さらに、エンジニアは物理的なリアリズムと幾何学的なディテールを可能な限り盛り込みたいと考えているため、複雑さを増す高忠実度のデジタルツインを作成する必要性が高まっています。したがって、高速メッシングは、エンジニアが製品開発を加速し、製品をより早く市場に投入できるようにする、競争上の優位性をもたらす戦略的なイネーブラーです。これをサポートするために、私たちはCFDワークフローを加速し、数多くの設計バリエーションを迅速に評価できるようにするソリューションを追求しています。メッシングの場合、個々のワークフローの最適化から、MPI(Message Passing Interface)による分散メモリ並列化、すなわち複数のCPUで同時にメッシングタスクを実行する機能まで、あらゆるものがこれに含まれます。
このブログでは、Simcenter STAR-CCM+の最近の機能強化により、メッシングパフォーマンスがどのように向上し、エンジニアがシミュレーションスループットを向上させ、より迅速な洞察を得られるようになったかをご紹介します。
MPIサーフェスラッピングによるジオメトリクリーンアップの高速化
Simcenter STAR-CCM+の主な差別化ポイントの1つは、エンジニアが複雑な形状を扱えるようにする、CADからソリューションへのパイプラインワークフローです。多くのシミュレーションワークフローでは、何万ものパーツを含む巨大なCADアセンブリが使用されます。これらのCADファイルには、非常に大きなアセンブリや「ダーティ」な形状が含まれていることがよくあります。ダーティ」とは、穴が空いていたり、交差していたり、デフィーチャリングが必要であったり、重なりがあったり、多様体でない頂点やエッジが含まれていたりする入力ジオメトリのことです。このようなジオメトリを手作業でクリーニングおよびヒーリングすることは、労力のかかるプロセスであり、完了までに数日から数週間かかる可能性があります。
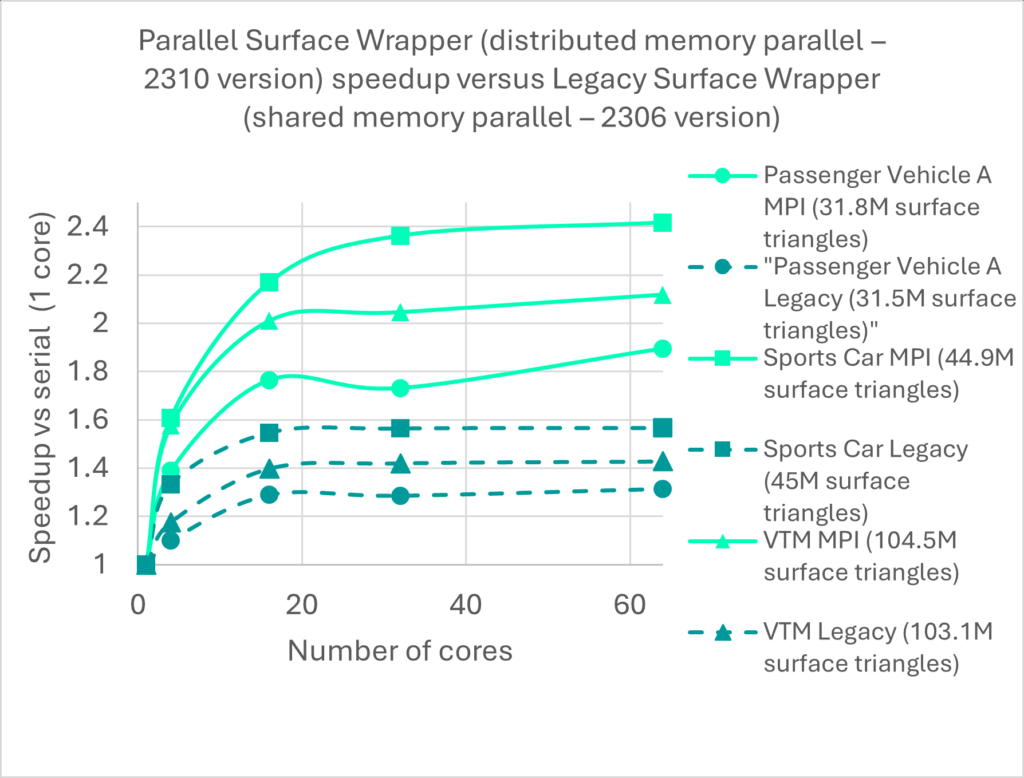
Simcenter STAR-CCM+でメッシュ作成用の形状を準備するための重要なツールの1つがサーフェスラッパーです。サーフェスラッパーは、任意に複雑なCADやテッセレーションされたパーツを扱い、水密で多様なサーフェスを生成することができます。この機能は、離散化されたジオメトリ上に高品質な三角形分割されたサーフェスメッシュを効果的に「シュリンクラップ」することで機能します。主な強みの1つは、シャープエッジやコーナーなどの幾何学的特徴を正確に保持できることです。Simcenter STAR-CCM+のバージョン2310では、サーフェスラッパーの最初のMPI並列化バージョンを導入し、”Legacy Wrapper “としても知られる共有メモリ並列化バージョンよりも大幅にパフォーマンスを向上させました。その最初のバージョンでは、Legacy Wrapperと比較して、ラッピング時間を最大43%削減することを実証しました。
 図1: MPIサーフェスラッパーフェーズ1、2310バージョン
しかし、この性能向上は、非常に大規模なケースでは十分ではありません。継続的な改善へのコミットメントに基づき、Simcenter STAR-CCM+ 2510バージョンでは、MPI Surface Wrapperのフェーズ2をリリースします。性能向上について見てみましょう。

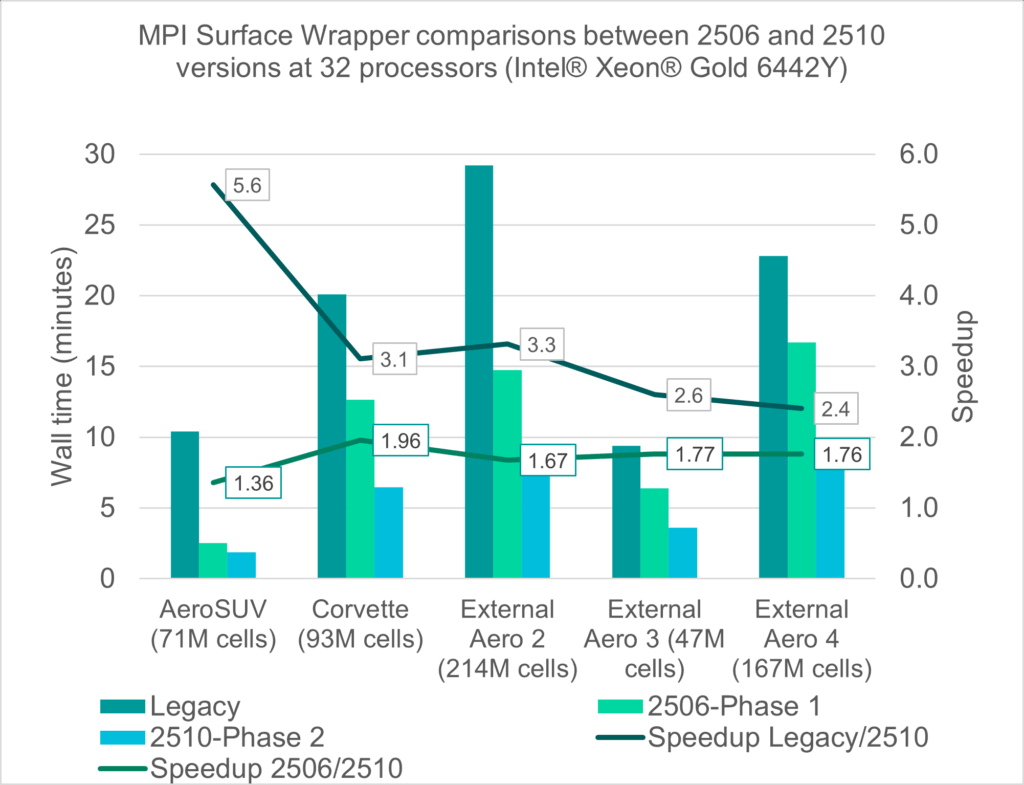
図2に示すように、バージョン2510のMPIサーフェスラッパーは、バージョン2506(MPIサーフェスラッパーのフェーズ1)と比較して、最大2倍の高速化を実現しています。レガシーWrapperと比較すると、最大5.6倍のスピードアップに達します。Corvette carのような複雑なジオメトリ(総ボリュームメッシュ数が93Mセル)の場合、32コア(Intel® Xeon® Gold 6442Y)でジオメトリ全体をラップするのにかかる時間はわずか6.5分です。
図2: MPIサーフェスラッパーフェーズ2より大きなケースのラッピングはどうでしょうか?Corvetteのケースでは、Surface Wrapperは37.4Mのサーフェス三角形を生成します。これに対して、マセラティ・ギブリのケースは、下図のようにかなり大きく、56.3Mトライアングルのラッピングに9分しかかからず、最終的なボリュームメッシュは142Mセルになります。